W skrócie
- Urządzenie: M5Stack Core2
- Procesor: ESP32
- Backend: Node.js + Gemini
Wyzwanie
Postać miała być nieznośna i użyteczna jednocześnie, a te dwa wymagania ciągną w przeciwne strony. Żart przestaje być śmieszny w sekundzie, w której zaczyna przeszkadzać w rozwiązaniu problemu. Do tego cały ciężki pipeline (rozpoznawanie mowy, generowanie odpowiedzi, synteza głosu) nie miał jak zmieścić się na ESP32, a klucze API wgrane do firmware oznaczałyby rozdanie ich każdemu, kto weźmie urządzenie do ręki. I jeszcze ekran: 320×240 pikseli bez wygładzania, na którym emocje muszą być czytelne z drugiego końca pokoju.
Rozwiązanie
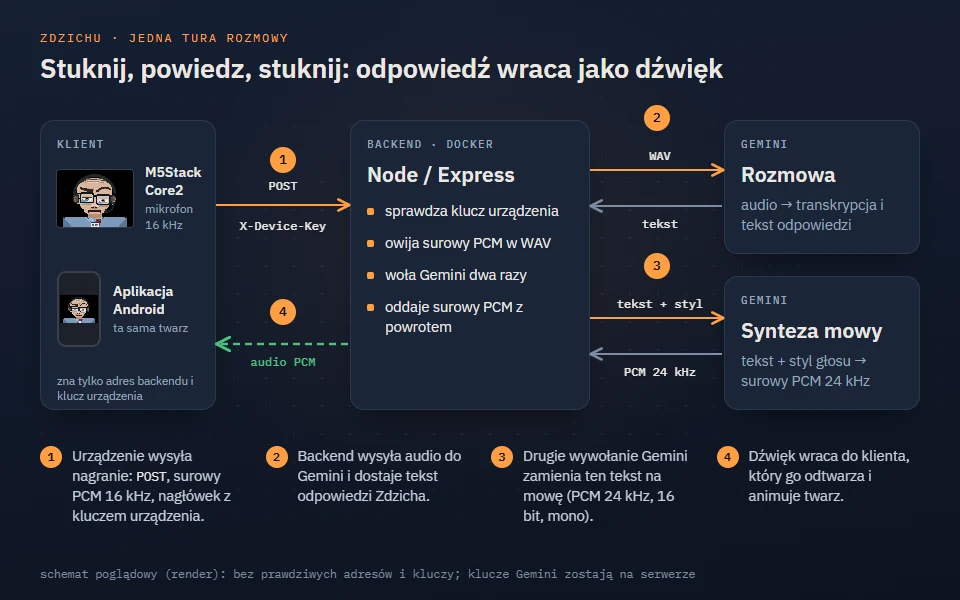
Urządzenie jest cienkim klientem: zna wyłącznie adres backendu i jeden współdzielony sekret, zero kluczy API na sprzęcie. Jedna tura rozmowy to jedno żądanie: surowe PCM leci POST-em do backendu w Dockerze na moim VPS-ie, tam Gemini robi transkrypcję i odpowiedź w jednym przejściu, osobno syntezę mowy, a wraca gotowe audio. Emocje rozwiązałem jak manometr, nie jak minę: pięć stanów twarzy, w których w trakcie jednej odpowiedzi wypiek wściekłości wspina się od kołnierzyka w górę i kończy wybuchem, a pod całym jadem prompt systemowy pilnuje, żeby została działająca odpowiedź, bo to jedyny zawodowy obowiązek Zdzicha. Backend pamięta ostatnie wypowiedzi z rozmowy przez 20 minut, więc da się dopytać.
Proces
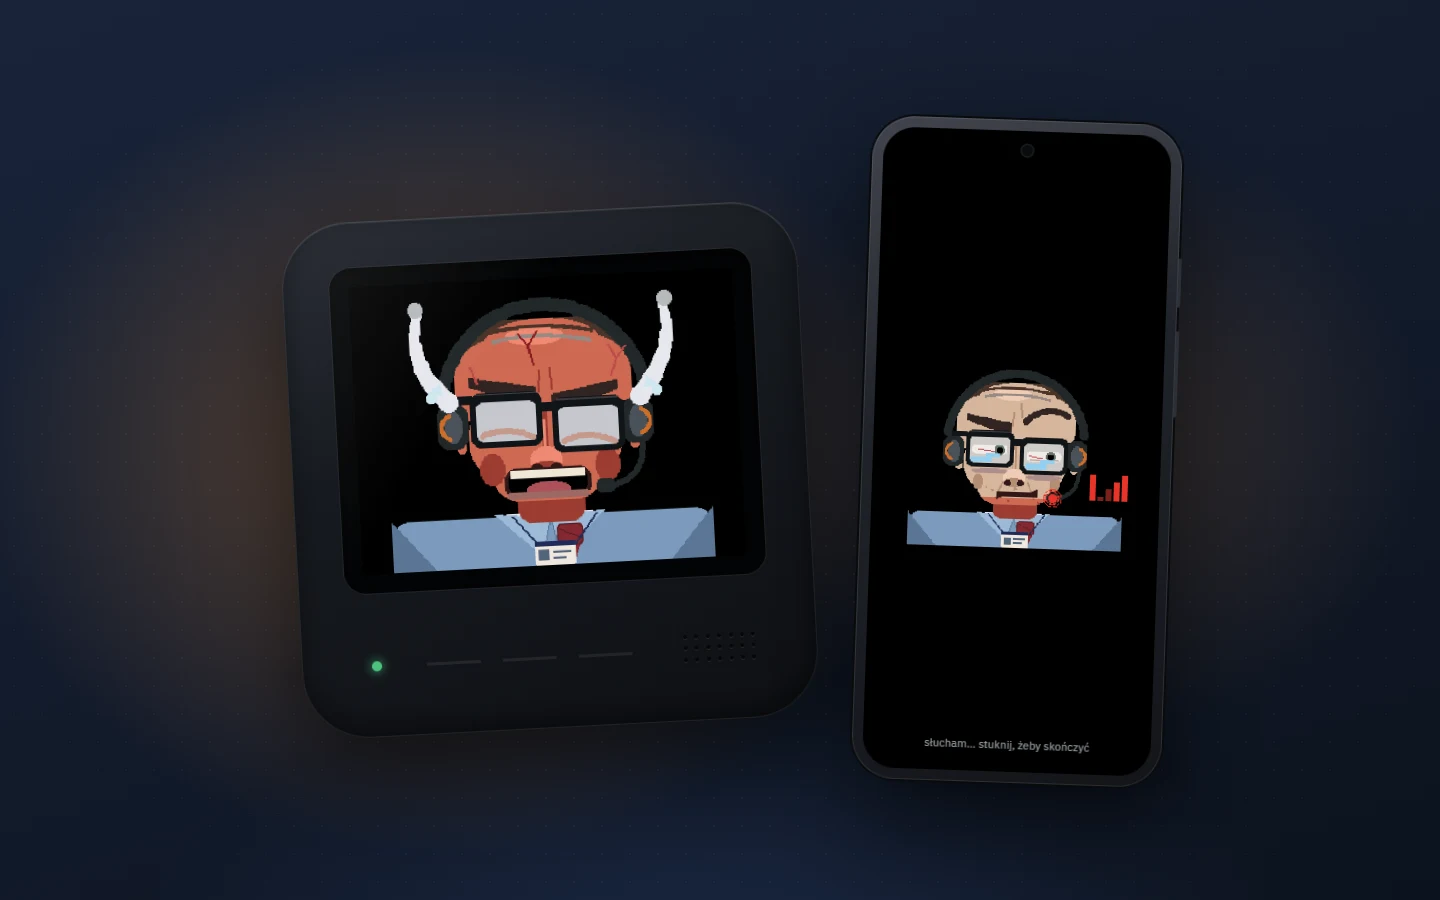
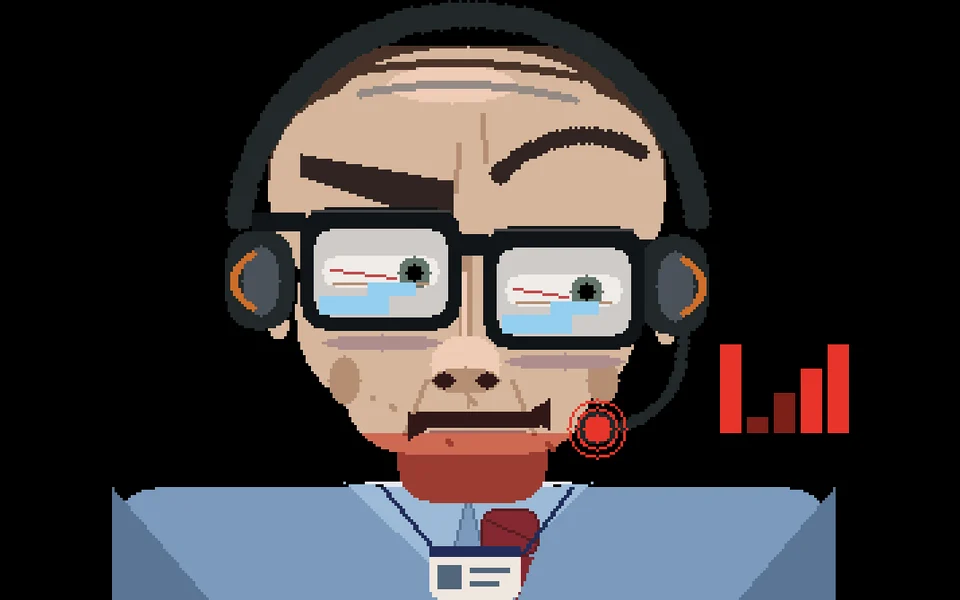
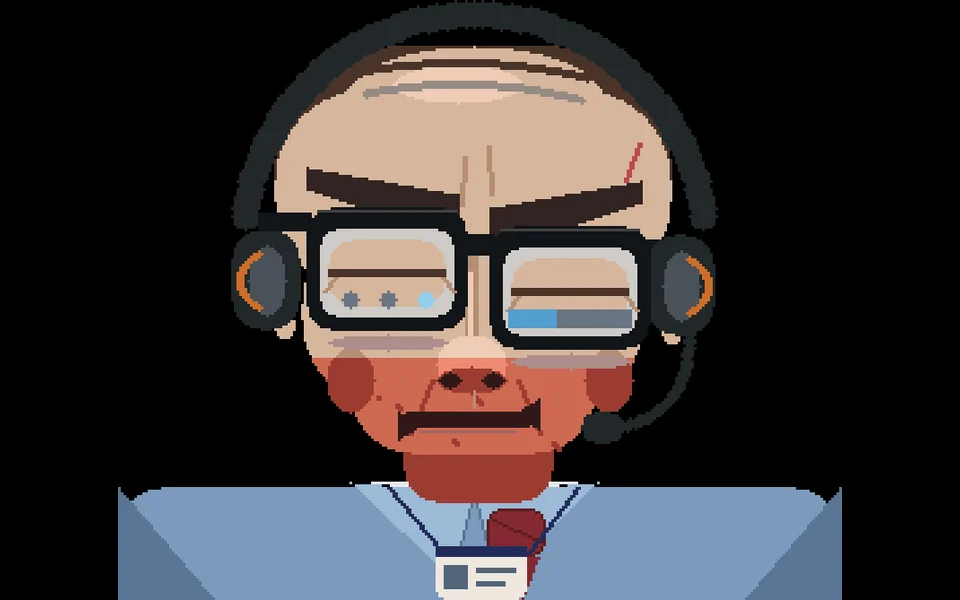
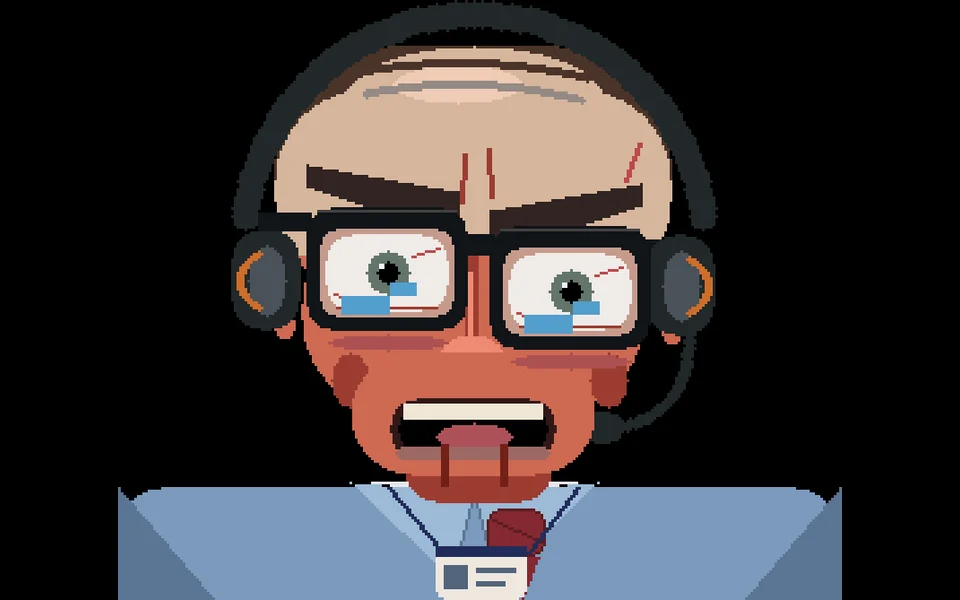
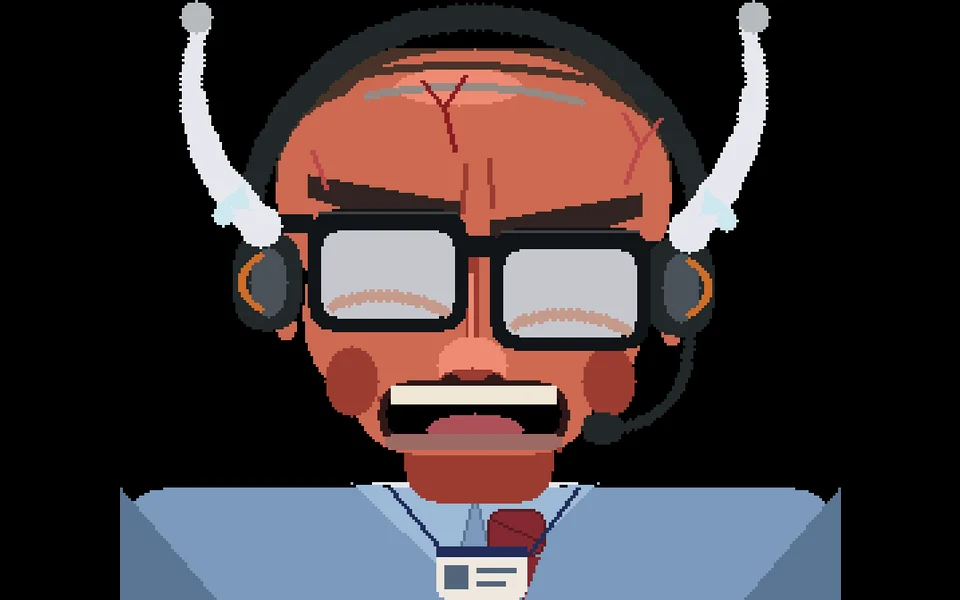
- Twarz jako maszyna stanów: pięć stanów rysowanych tym samym zestawem pikselowych prymitywów wprost na ekranie 320×240, bez wygładzania i bez bitmap.
- Sterowanie głosem: tap-to-talk na dotykowej twarzy, nagranie 16 kHz / 16-bit mono (do 10 s), drugi tap kończy i wysyła.
- Backend w Node.js (Express) w Dockerze: jedno żądanie na turę, sekret urządzenia w nagłówku, surowe PCM w ciele; krótka pamięć rozmowy w RAM kontenera.
- Warstwa modelu: Gemini zwraca transkrypcję i odpowiedź w jednym przejściu (wynik w JSON), potem osobno syntezę mowy, a prompt systemowy trzyma granicę między jadem a treścią.
- Port na Androida: te same współrzędne twarzy co w firmware i ten sam protokół, więc aplikacja i urządzenie rozmawiają z tym samym backendem.
- Konfiguracja WiFi w terenie: urządzenie bez znanej sieci wystawia własny hotspot z portalem konfiguracyjnym, a sieć można zresetować przytrzymaniem ekranu przy starcie.
- Wdrożenie: GitHub Actions buduje i publikuje obraz backendu przy każdym pushu, a stack na własnym VPS-ie, za Nginx Proxy Managerem, go uruchamia.
Jak to wygląda
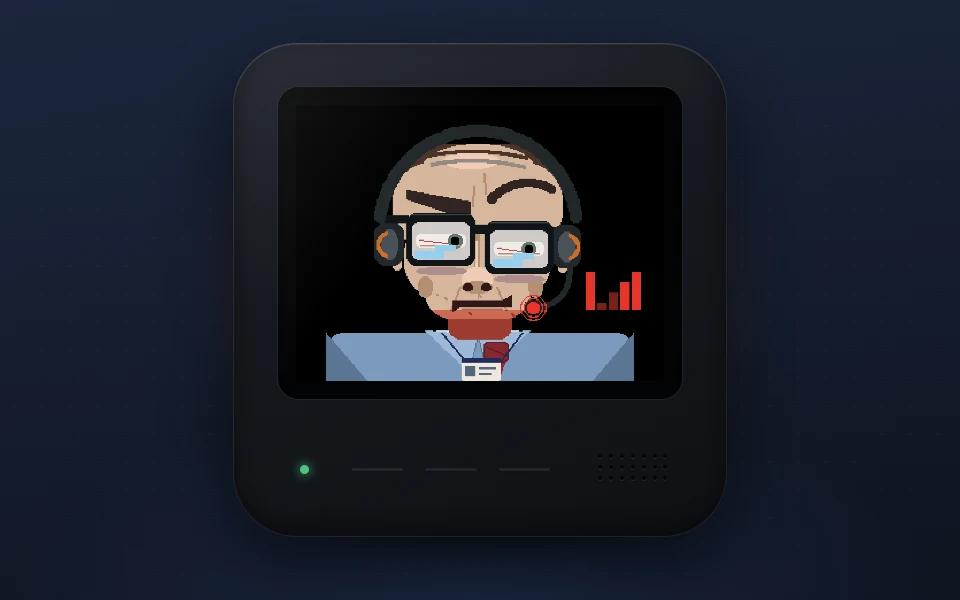
Wszystkie obrazy poniżej to rendery wykonane z kodu twarzy i makiety, nie zdjęcia urządzenia ani zrzuty z telefonu.
Co potrafi
- Tap-to-talk. Stukasz w twarz, mówisz, stukasz znowu. Żadnego przycisku, żadnego słowa aktywującego i żadnego nasłuchu w tle.
- Twarz jak manometr. Pięć stanów: spokój, nasłuch, myślenie, mówienie i eskalacja. W trakcie jednej odpowiedzi wypiek wściekłości wspina się od kołnierzyka w górę, a na końcu pokrywa puszcza.
- Zero kluczy na sprzęcie. Urządzenie zna tylko adres backendu i jeden współdzielony sekret. Klucze do modelu zna wyłącznie backend, więc rozkręcenie obudowy nic nie daje.
- Jedna tura, jedno żądanie. Nagranie w surowym PCM idzie jednym POST-em, wraca gotowe audio, bez sesji do utrzymywania po stronie urządzenia.
- Pamięć rozmowy. Backend pamięta ostatnie tury przez 20 minut (jako tekst, w pamięci kontenera), więc Zdzichu pamięta, czym Cię przed chwilą obraził. Po restarcie zaczyna od zera.
- Ta sama twarz na Androidzie. Aplikacja to port 1:1 współrzędnych z firmware i rozmawia z tym samym backendem, tym samym protokołem. Bez zewnętrznych bibliotek.
- Głos zamiast napisów. Odpowiedź wraca jako mowa (synteza Gemini, głos „Charon”) i odtwarza się, gdy cała dotrze do urządzenia.
- Sarkazm z granicą. Na system i świat Zdzichu bluzga jak szewc, ale wobec użytkownika trzyma lodowaty, chirurgicznie precyzyjny sarkazm bez wulgaryzmów, to celowa granica wpisana w prompt.
- WiFi bez przeprogramowywania. Nowa sieć ustawia się z telefonu przez własny hotspot urządzenia, bez ruszania kodu.
- Własna infrastruktura. Cały pipeline stoi w Dockerze na moim VPS-ie, a obraz buduje się sam przy każdym pushu.
Dane techniczne
- Urządzenie: M5Stack Core2 (ESP32, ekran 320×240)
- Firmware: C++ / M5Unified (PlatformIO, Arduino)
- Aplikacja: Android 8+ (Kotlin, bez zewnętrznych bibliotek)
- Backend: Node.js (Express) w Dockerze, własny VPS
- Model: Gemini: transkrypcja, odpowiedź i synteza mowy (modele preview)
- Audio: nagranie 16 kHz / 16-bit mono, odtwarzanie 24 kHz
- Wdrożenie: GitHub Actions (obraz), Portainer, Nginx Proxy Manager
Prywatność
Urządzenie nie zna żadnego klucza do modelu, ma tylko adres backendu i jeden współdzielony sekret w nagłówku żądania, więc dostęp do sprzętu nie daje dostępu do API. Samo nagranie jest przetwarzane po drodze: idzie do mojego backendu, a stamtąd do Gemini po transkrypcję, odpowiedź i syntezę głosu. Nic nie nagrywa się w tle, mikrofon startuje dopiero po stuknięciu w twarz i kończy po drugim stuknięciu.